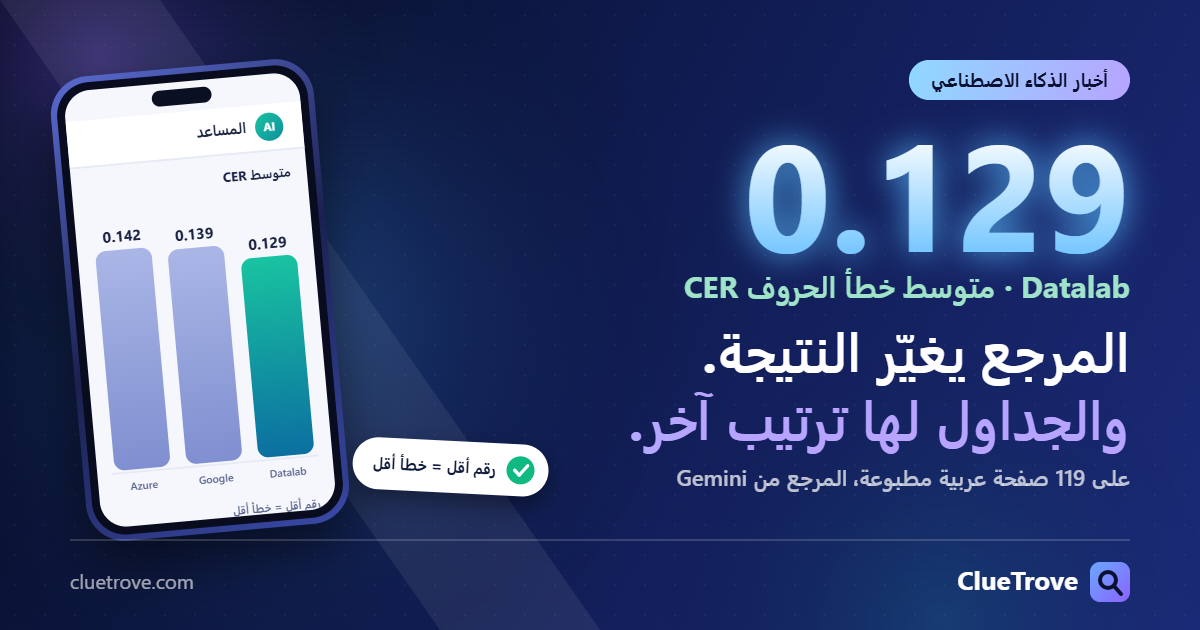
على 119 صفحة عربية مطبوعة سجّل Datalab أقل معدل خطأ في الحروف CER بمتوسط 0.129، يليه Google Document AI بـ0.139 ثم Azure Document Intelligence بـ0.142. وفي 22 جدولًا عربيًا كان Azure الأفضل بـ0.173.
لكن النص المرجعي نفسه ولّده نموذج Gemini ولم يُراجَع على صور الصفحات. فالأرقام تقيس التوافق مع ذلك المرجع وليست دقة موثقة. المصدر دراسة على arXiv برقم 2610.25235 قُدّمت في 18 أكتوبر 2026، وقد قرأنا الورقة في 22 أكتوبر 2026.
الخلاصة أولًا
- العربية المطبوعة: Datalab الأقل خطأً بمتوسط CER 0.129 على 119 صفحة.
- الجداول العربية: Azure الأفضل بـ0.173 على 22 جدولًا.
- المرجع: ولّده نموذج Gemini ولم يُراجَع على صور الصفحات.
- المعنى: الأرقام تقيس التوافق مع المرجع وليست دقة موثقة.
كيف جاءت النتائج؟
قارنت الدراسة أنظمة OCR سحابية وذاتية الاستضافة على مستندات عربية وإنجليزية وفرنسية.
| النظام | CER للنص العربي المطبوع (119 صفحة) | CER للجداول العربية (22 جدولًا) |
|---|---|---|
| Datalab | 0.129 | 0.327 |
| Google Document AI | 0.139 | 0.410 |
| Azure Document Intelligence | 0.142 | 0.173 |
| Surya، ذاتي الاستضافة | 0.203 | 0.374 |
| olmOCR 2 | 0.225 | 0.585 |
| PaddleOCR-VL | 0.326 | 0.488 |
| Qwen3-VL | 0.363 | 0.576 |
| Tesseract | 0.368 | 0.322 |
| KATIB | 0.373 | 0.631 |
| dots.ocr | 0.602 | 0.434 |
الأقل أفضل. معدل CER هو نسبة الحروف المختلفة عن النص المرجعي.
ماذا تقول الأرقام فعلًا؟
الفرق بين الأنظمة الثلاثة الأولى في النص المطبوع صغير. بين Datalab وAzure 0.013 بحسابنا، أي 0.142 ناقص 0.129. أما في الجداول فالفرق كبير: Azure بـ0.173 مقابل Datalab بـ0.327 وGoogle Document AI بـ0.410.
ويذكر الملخص أن متوسط CER لـDatalab وAzure وDocument AI بين 0.145 و0.152 إجمالًا، دون فرق مرصود في المقارنات الزوجية غير المعدّلة. أي أن الأنظمة الثلاثة متقاربة عمومًا، والنظام الأفضل في نوع مستندات قد لا يكون الأفضل في غيره.
ولاحظ أن Tesseract سجّل 0.322 في الجداول، وهو أقل من Datalab وGoogle وSurya. فالترتيب في النص المطبوع لا ينتقل تلقائيًا إلى الجداول.
ماذا اختبرت الدراسة؟
اختبر المؤلفون (الصبحي وزملاؤها) ثلاثة أمور: كشف الصناديق المحيطة على 48 صفحة، والتعرف على النص على 315 صفحة من تسعة أنواع مستندات، منها 174 عربية و105 فرنسية و36 إنجليزية، والتعرف على التعابير الرياضية على 83 عينة.
وشغّلت الأنظمة ذاتية الاستضافة على بطاقة NVIDIA RTX A6000 واحدة بذاكرة 48 جيجابايت.
لماذا لا تقرأ هذا كقائمة فائزين؟
- ولّد Gemini 3.1 Flash-Lite النصوص المرجعية لأنه لا يوجد نسخ بشري لمعظم الصفحات. وتقول الورقة إن هذا المرجع لم يُتحقق منه باستقلال مقابل صور المصدر.
- تقول الورقة إن Gemini قد يوحّد الأرقام أو علامات الترقيم. والدرجات القريبة من الكمال قد تخفي أخطاء مثل استبدال متغير عربي أو كتابة الأرقام الهندية بالغربية.
- مجموعات المستندات منتقاة عمدًا وليست ممثلة إحصائيًا لكل المجموعات، والمقارنات حسب النوع استكشافية.
كيف تختار لمستنداتك العربية؟
- اختر عينة من صفحاتك العربية وراجع نصها يدويًا لتكون مرجعك.
- شغّل مرشحين أو ثلاثة عليها وقارن الأرقام والتواريخ.
- اختبر الجداول على حدة عن النص المطبوع.
- تحقق من الأسعار والإصدارات والمناطق وشروط الترخيص قبل النشر، فهذا ما تنص عليه الورقة نفسها.
نقترح أن تعدّ الأرقام نقطة بداية للفرز، لا قرار شراء. فمرجع راجعته بنفسك أوثق من مرجع ولّده نموذج.
أسئلة وأجوبة حول دقة OCR العربي
أي نظام OCR سجّل أقل خطأ في العربية المطبوعة؟
Datalab بمتوسط CER 0.129 على 119 صفحة، مقابل مرجع ولّده Gemini.
وأيها الأفضل في الجداول العربية؟
Azure Document Intelligence بـ0.173 على 22 جدولًا.
هل هذا إثبات لأفضل OCR عربي؟
لا. يقول المؤلفون إن CER يقيس التوافق مع مرجع ولّده نموذج وليس دقة موثقة.
كم صفحة وعينة اختُبرت؟
48 صفحة لكشف الصناديق، و315 صفحة للتعرف على النص، و83 عينة للتعابير الرياضية.
على أي عتاد شُغّلت الأنظمة ذاتية الاستضافة؟
على بطاقة NVIDIA RTX A6000 واحدة بذاكرة 48 جيجابايت.
مصطلحات بلغة مبسطة
- OCR: التعرف الآلي على النص داخل صور المستندات.
- CER: نسبة الحروف المختلفة عن النص المرجعي؛ الأقل أفضل.
- النص المرجعي: النص الذي تُقارن به مخرجات الأنظمة.
- ذاتي الاستضافة: نظام تشغّله على جهازك أو خادمك بدل خدمة سحابية.
المصادر
- arXiv: تقييم أنظمة OCR السحابية وذاتية الاستضافة للمستندات العربية والإنجليزية والفرنسية (قُرئ في 22 أكتوبر 2026)
- arXiv نسخة HTML، الإصدار 1
قُرئت المعلومات في 22 أكتوبر 2026.