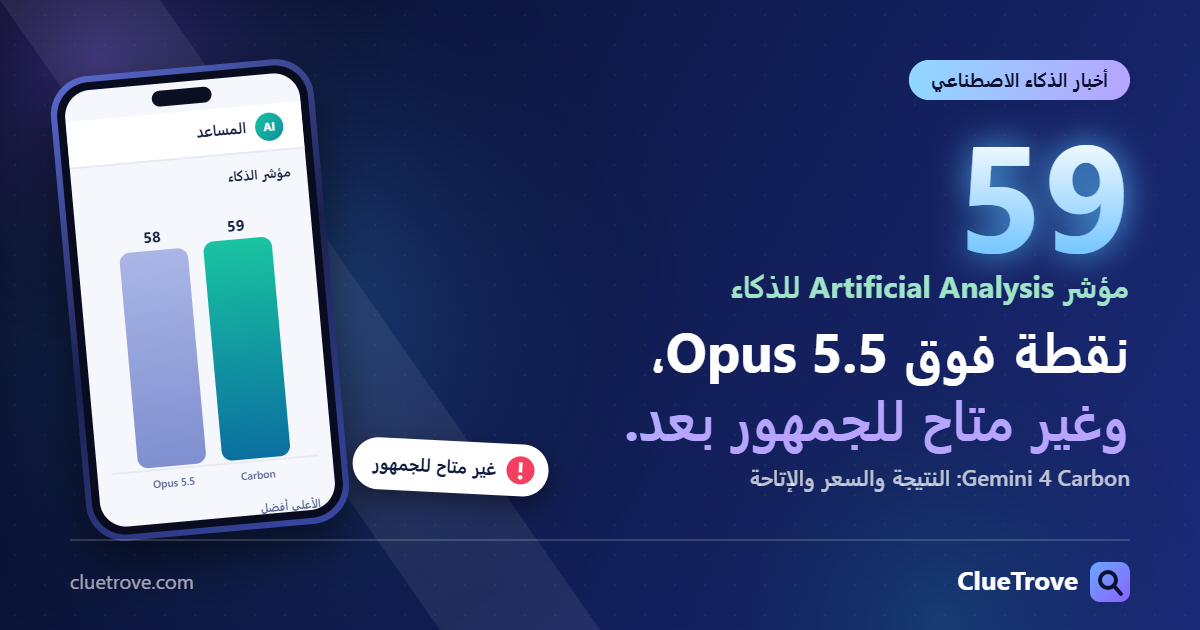
تصدّر Gemini 4 Carbon من Google مؤشر Intelligence Index v5 بدرجة 59، متقدمًا بنقطة واحدة على Claude Opus 5.5. والرقم الأهم لميزانيتك أن المهمة الواحدة عليه تكلف 7.76 دولارات، أي أقل من Opus بنحو 23%، لكنك لا تستطيع استخدامه إلا إذا كنت من المدافعين السيبرانيين.
الخلاصة أولًا
- المؤشر العام: Carbon بإعداد High يسجل 59، وClaude Opus 5.5 بإعداد Max يسجل 58، وGPT-6 Astra بإعداد Max يسجل 57. فرق نقطة لا يغيّر النموذج الذي تختاره.
- وكلاء البرمجة: يسجل Carbon مع Antigravity CLI درجة 59، بينما يسجل Claude Code مع Opus 5.5 بإعداد Max درجة 62. في البرمجة ما زال Opus في المقدمة.
- عمل المعرفة: في AA-Briefcase يحصل Carbon على 1,609 Elo، وثلاثة نماذج أعلى منه، منها Grok 4.7 بإعداد xhigh عند 1,638.
- السعر: دولاران للمليون رمز إدخال و10 دولارات للإخراج في الفترة الافتتاحية، ثم 4 و20 دولارًا. لم تعلن Google موعد انتهاء الفترة الافتتاحية.
- الوصول: مجموعة من المدافعين السيبرانيين الآن، ثم شركاء موثوقون. المطورون والشركات والمستهلكون لاحقًا بلا موعد.
أين يتفوق Carbon فعلًا؟
نشرت Artificial Analysis، وهي جهة مستقلة لقياس النماذج، نتائجها في 28 أكتوبر. يحتل Carbon المركز الأول في المؤشر العام، ويحقق أعلى درجة في 4 من 9 اختبارات داخله: HLE-Diamond وTerminal-Bench-Science وAA-Omniscience وAutomationBench-AA.
| النموذج والإعداد | Intelligence Index v5 |
|---|---|
| Gemini 4 Carbon — High | 59 |
| Claude Opus 5.5 — Max | 58 |
| GPT-6 Astra — Max | 57 |
| GPT-6.1 Sol — Max | 55 |
| Gemini 4 Argon — High | 50 |
القفزة الحقيقية هي على Argon، نموذج Google السابق بأسبوعين. تسع نقاط كاملة. أما على المنافسين فالتقدم ضيق: نقطة على Opus ونقطتان على Astra.
وأقوى نتيجة منفردة جاءت في AA-Omniscience، اختبار المعرفة بالحقائق. سجل Carbon فيه 54، مقابل 48 لـOpus 5.5 و46 لـArgon. ودقته 58%، أي أعلى من Argon بعشر نقاط.
وأين يتأخر؟
في وكلاء البرمجة يسجل Carbon مع Antigravity CLI درجة 59 مقابل 62 لـClaude Code مع Opus 5.5. الاختبار يقيس النموذج والأداة معًا، فهو مقارنة بين منظومتين لا بين نموذجين فقط. والتفاصيل تؤكد ذلك: حقق Carbon 64% في Terminal-Bench 4.0 و51% في FrontierCode v1.1، وجاء ثانيًا في الاثنين. أما Opus 5.5 فسجل 56% في FrontierCode.
وفي AA-Briefcase، وهو تقييم Elo لعمل المعرفة، يسجل Carbon 1,609، أي أعلى من Argon بـ126 نقطة (1,483). لكنه دون Grok 4.7 بإعداد xhigh عند 1,638، وMuse Wonder بإعداد max عند 1,659، وKimi K3.1 Pro عند 1,678. وElo مقياس مختلف عن درجات المؤشر، فلا تخلط بينهما.
هل هو أرخص من Claude Opus؟
نعم في المهمة الواحدة، والسبب عدد الرموز. يكتب Carbon نحو 123 ألف رمز إخراج لكل مهمة في المؤشر، ويكتب Opus 5.5 نحو 173 ألفًا، أي أن Carbon يكتب أقل بـ29%. وتحسب Artificial Analysis الكلفة بالسعر القياسي، 4 دولارات للإدخال و20 للإخراج لكل مليون رمز، لا بالسعر الافتتاحي.
- Carbon: 7.76 دولارات للمهمة.
- Claude Opus 5.5 بإعداد Max: 10.04 دولارات.
- GPT-6 Astra بإعداد Max: 6.25 دولارات، فيكلف Carbon أكثر منه بنحو 1.2 مرة.
- Gemini 4 Argon: 7.68 دولارات بالأسعار نفسها. تسع نقاط إضافية في المؤشر مقابل 8 سنتات فقط للمهمة.
الدرس: قارن كلفة المهمة لا سعر الرمز. نموذج يفكر بإيجاز قد يغلب منافسًا يبدو أرخص. وهذه كلفة اختبار وليست فاتورة شهرية. وتخصم Google 95% من سعر الإدخال المخزّن مؤقتًا، أي 0.20 دولار للمليون رمز بالسعر القياسي. إن كان تطبيقك يعيد إرسال التعليمات الطويلة نفسها، فهذا أكبر توفير متاح لك.
هل يختلق معلومات أقل؟
معدل الهلوسة لديه في AA-Omniscience هو 11%، وهو ثاني أدنى معدل بين النماذج المقاسة بعد Argon الذي يسجل 4%. أما Claude Opus 5.5 وGPT-6 Astra بإعداد Max فكلاهما عند 50%. إن كان عملك قائمًا على المعلومات، كالبحث والتلخيص، فهذا سبب أقوى لمتابعة Carbon من الدرجة العامة.
من يستطيع استخدامه الآن؟
بدأ الوصول في أسبوع الإعلان لمجموعة من المدافعين السيبرانيين. وستوسعه Google تدريجيًا إلى شركاء موثوقين عبر برنامج Fairwind. بعد ذلك يأتي دور المطورين والشركات والمستهلكين، وتقول Google إن ذلك سيكون في أقرب وقت ممكن بعد جمع الملاحظات وتحسين الضوابط.
يقبل Carbon النص والصورة والفيديو والكلام مدخلات، ويخرج نصًا، ونافذة سياقه مليون رمز. وتقول Google إنه مصمم للمهام الطويلة، وإن فرقها الداخلية شغّلته أيامًا في مهام هندسية متعددة الخطوات.
وتنشر Google أيضًا نتائج أمنية قيست دون ضوابط حماية، منها 88.2% في SEC-bench Pro. هذه أرقام من Google نفسها.
من يهمه الأمر ومن يتجاهله؟
- يهمهم: فرق الأمن السيبراني (وهي مجموعة الوصول الحالية)، ومن يختار نموذجًا للعمل المعتمد على الحقائق أو ينفق مبالغ كبيرة على واجهة البرمجة.
- يتجاهلونه الآن: مستخدمو وكلاء البرمجة. Opus 5.5 مع Claude Code متقدم، وCarbon غير مفتوح لك أصلًا.
- لا تقارن v5 بالقديم: تغير المؤشر في 27 أكتوبر، وصار 60% من الإصدار الخامس قائمًا على مجموعات اختبار خاصة أو إجابات محجوبة.
لم يُعلن بعد: موعد الإتاحة العامة، وتاريخ انتهاء السعر الافتتاحي، وأي أرقام للسرعة.
ماذا تفعل هذا الأسبوع؟
- لا تبنِ خطة انتقال. لا يوجد موعد للإتاحة العامة.
- أبقِ إعداد البرمجة الحالي. Carbon يتأخر عنه بثلاث نقاط.
- عند فتح الوصول، جرّبه على بضع مهام من عملك وقارن كلفة المهمة والجودة. المؤشر متوسط مهام كثيرة.
- احسب ميزانيتك على 4 و20 دولارًا لا 2 و10، فالسعر الافتتاحي قد ينتهي دون إنذار.
مقال ذو صلة: GitHub Copilot Fusion: كيف يعمل، وكم يكلف، وأي خطة تحتاج؟، ويستعمل مؤشر وكلاء البرمجة نفسه.
أسئلة وأجوبة
هل Carbon أفضل نموذج للبرمجة؟
لا. درجته 59 في مؤشر وكلاء البرمجة، أقل بثلاث نقاط من Claude Code مع Opus 5.5 البالغة 62. ويتأخر عن Opus أيضًا في FrontierCode: 51% مقابل 56%.
هل Carbon أرخص من Claude Opus 5.5؟
في المهمة الواحدة نعم. تقدّر Artificial Analysis كلفته بـ7.76 دولارات مقابل 10.04، أي أقل بنحو 23%، لأنه يكتب رموز إخراج أقل. وGPT-6 Astra أرخص منهما بـ6.25 دولارات.
هل سعر 2 و10 دولارات دائم؟
لا. تعلن Google سعرًا لاحقًا هو 4 و20 دولارًا للمليون رمز، والسعر الافتتاحي نصفه. فاحسب ميزانيتك على الرقم الأعلى.
كم يتفوق Carbon على Gemini 4 Argon؟
بتسع نقاط في المؤشر، 59 مقابل 50، وبـ126 نقطة Elo في AA-Briefcase. وكلفة المهمة متقاربة، 7.76 مقابل 7.68 دولارًا. لكن Argon يحتفظ بأدنى معدل هلوسة: 4% مقابل 11%.
لماذا يهم إعداد الجهد عند قراءة الدرجات؟
لأنه يغيّر النتيجة كثيرًا. تذكر Artificial Analysis أن Claude Opus 5.5 يسجل 35 بجهد منخفض و58 بإعداد Max. تأكد دائمًا أن النموذجين قيسا بإعداد متقارب.
مصطلحات بلغة مبسطة
- الرمز: قطعة صغيرة من النص يقرؤها النموذج ويكتبها. تُسعّر الخدمة لكل مليون رمز.
- Elo: تقييم يرتفع عندما يفوز النموذج في المقارنات المباشرة.
- وكيل البرمجة: أداة تسمح للنموذج بتعديل الكود وتشغيل الأوامر بنفسه.
- إعداد الجهد: مثل High وMax، ويحدد مقدار التفكير الذي يبذله النموذج. تتغير الدرجة به.
- معدل الهلوسة: نسبة المرات التي يعطي فيها النموذج جوابًا خاطئًا بدل أن يقول إنه لا يعرف.
المصادر
- Google: إعلان Gemini 4 Carbon
- Artificial Analysis: نتائج Gemini 4 Carbon
- Artificial Analysis: Intelligence Index v5
لم نجرب النموذج في ClueTrove. المقال ينقل إعلان Google ونتائج Artificial Analysis المنشورة.
آخر تحقق من المعلومات: 29 أكتوبر 2026